深入底层与生产落地:LangGraph 状态机机制与高性能流式优化
前言 最近回过头重新审视并优化了之前的 LangGraph 项目。随着对大模型工程化与 Agent 架构理解的加深,发现不少早期写得不够优雅、甚至隐藏着生产风险的地方。本文不谈虚无缥缈的概念,我直接从底层机制进行拆解:MessagesState 的追加本质、RunnableConfig 的真实作用、
浅谈 LangGraph 智能体演进:从 Ollama到 DeepSeek-R1的踩坑与架构重构
前言 在本地部署大模型开发Agent项目,基于现有硬件环境和调试成本考量,优先使用的是基于Ollama部署的3B/7B模型。但当业务进入“海关风控与跨境物流”这种对指令遵循、工具调用以及人工干预有绝对硬红线的真实场景时,小模型的劣势会被无限放大。 本文记录了我将一个 LangGraph Agent
浅谈 HITL 与 Checkpointer
前言 本地跑通了 Multi-Agent 之后,我一直在想,企业级 AI 应用的两个关键技术还没真正用上:一个是 HITL(Human-in-the-Loop,人工介入),一个是 Checkpointer(状态持久化与回滚)。正好最近在研究跨境物流报关场景——这个领域因为涉及海关监管,人工审核是硬性
聊一下 LangGraph 的流式打印
在把项目从 LangChain 升级到 LangGraph 的过程中,最让人头疼的既不是节点状态(State)的定义,也不是 Redis Checkpointer 的持久化挂载,而是流式打印(Streaming Output)。 明明代码写得毫无 Bug,逻辑边和 HITL 人工中断也都流畅运行,但
调试 Cursor 与 Claude Code
前言 Cursor 和 Claude Code 这两个工具在AI圈子里讨论得热火朝天,我也打算在本地上手实战演练一下。 本地部署完并调试使用过后,感觉这两工具没有想象中那么强大,Cursor还需要自己去手动粘贴,他不具备直接修改操作文件的权限,而Claude消费token惊人,在项目搭建脚手架和重点
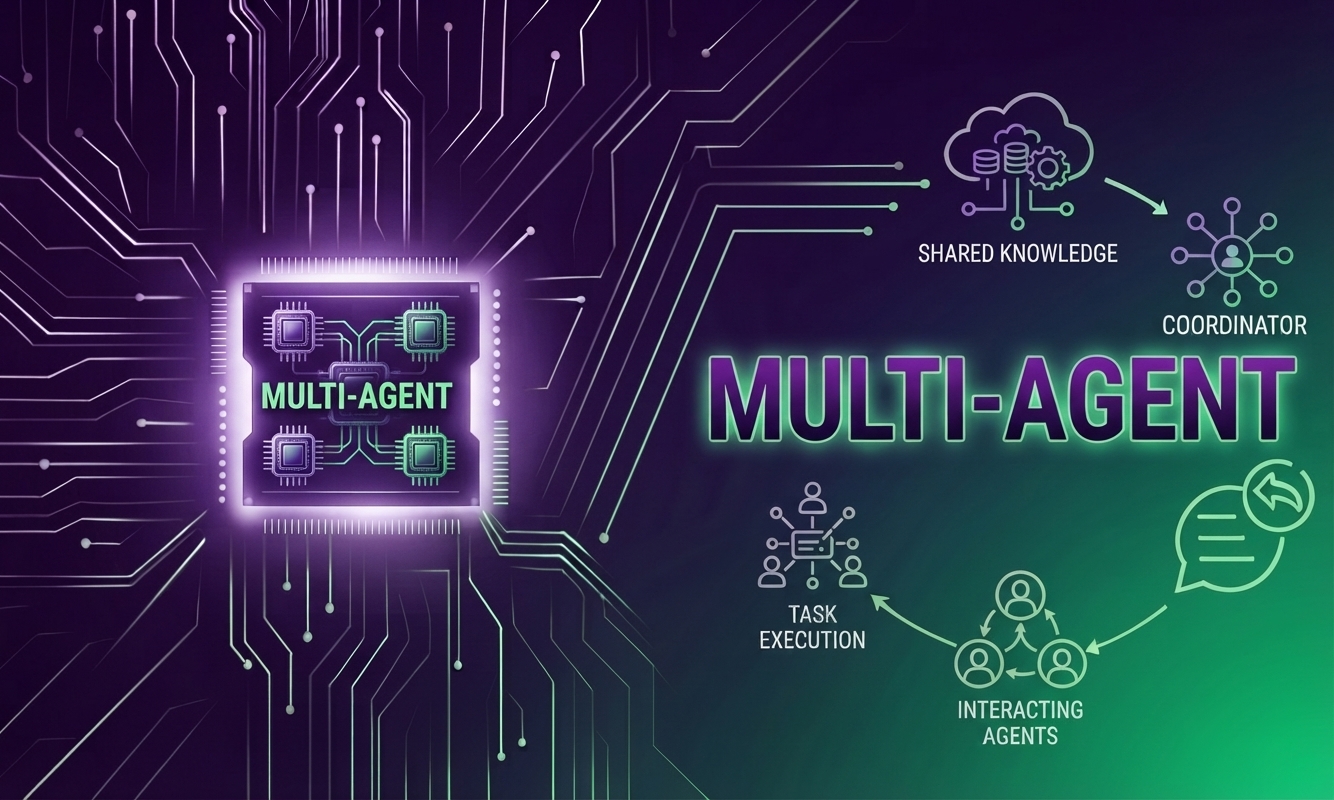
浅谈升级Multi-Agent
前言 本地已经跑通了LangGraph,现在要在此基础上搭建 Multi-Agent 架构。 受限于本地硬件环境决定用 3B 级别的参数去驱动复杂 Agent 图谱,但是痛点非常密集,意图路由漂移、冷门实体识别缺失、工具调用犹疑,以及随着 Context 增长导致的推理延迟暴增。 经过不断的链路重构
RAG 性能调优实战
前言 完成 LangGraph Agent 的整合后,一个简单的知识库查询,消耗响应时间比较长,延迟到一分钟以上,在我笔记本性能有限的情况下,采取了一些优化措施,让性能得到了提升,下面做一些总结: 1、让Ollama使用GPU加速: 问题表象 打开 Langfuse 的 Trace 一看,性能瓶颈一
浅谈Langfuse 生产级全链路观测与排坑指南
前言 Langfuse 作为目前开源界最出色的 LLM 可观测工具,支持全链路 Trace 追踪、Prompt 管理和成本分析。 我今天在本地 Docker 私有化部署了Langfuse及结合到之前的 LangChain/LangGraph项目 ,下面记录总结一些重要的节点和注意事项。 一、 私有化
浅谈治理RAG 混合检索+重排序 (续)
前言 在使用普通检索(倒排索引/BM25)的项目里,检索算法本身是看字不看意,导致命中率不高,给出的结果也不够准确,这个时候需要升级两种技术,混合检索、重排序。 先说一下混合检索、重排序: 混合检索:BM25关键词检索+向量检索+RRF公平合并(由看字变为理解意思在找) 重排序:根据原文深层理解后重
浅谈治理RAG 升级RAG 混合检索+重排序
前言 之前搭建的LangChain和LangGraph,使用的RAG有点不太准确,会出现幻觉,即答非所问,比如: 问"变速箱油多久换一次",知识库里明明有答案,系统会回"建议参考用户手册"。 LLM 没在知识库里找到答案,但被要求必须回答,于是用通用知识硬编。 检索这块需要升级,打算采用混合检索和重