RAG 性能调优实战
前言
完成 LangGraph Agent 的整合后,一个简单的知识库查询,消耗响应时间比较长,延迟到一分钟以上,在我笔记本性能有限的情况下,采取了一些优化措施,让性能得到了提升,下面做一些总结:
1、让Ollama使用GPU加速:
问题表象
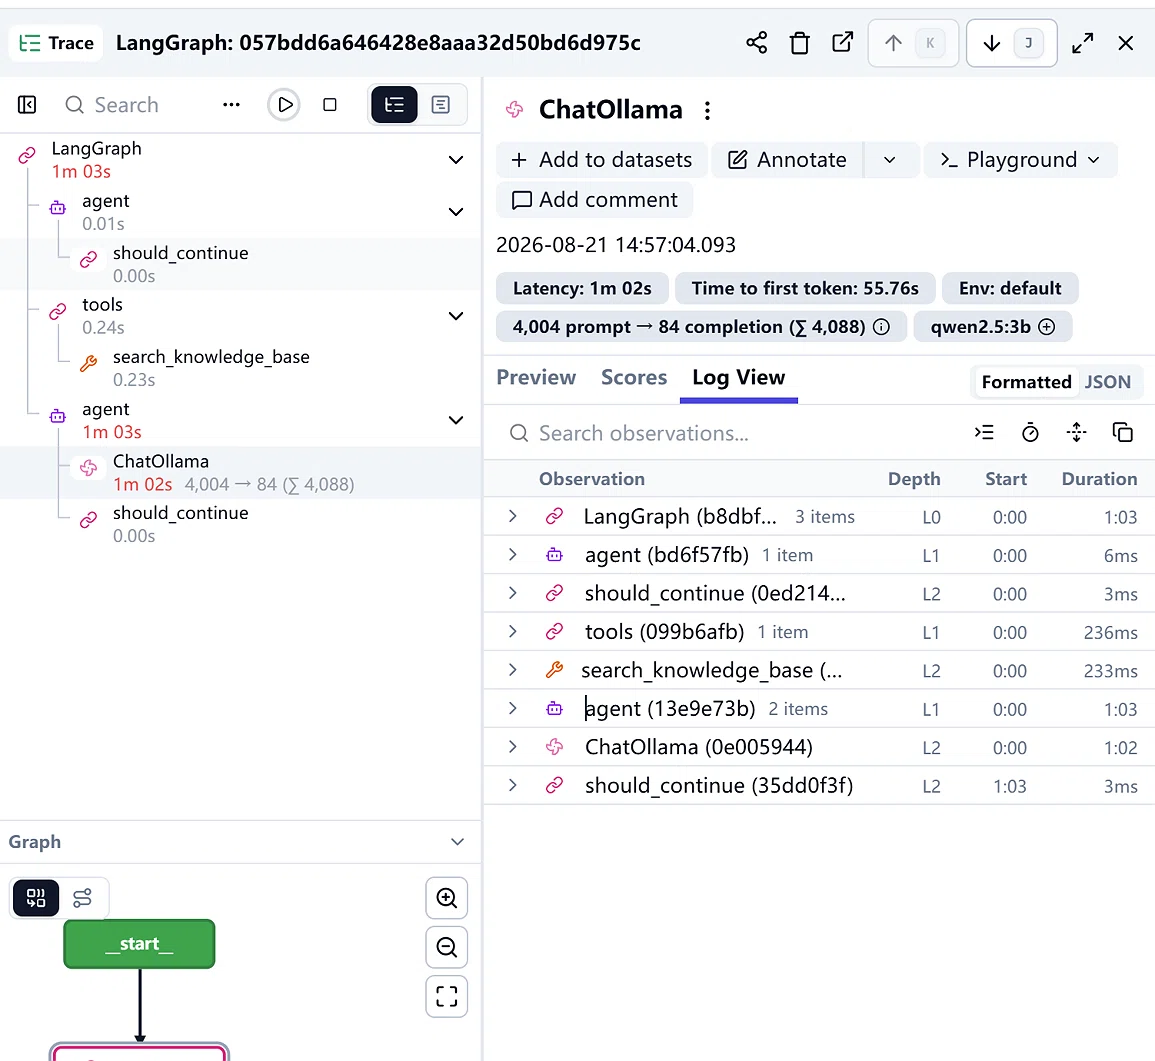
打开 Langfuse 的 Trace 一看,性能瓶颈一目了然:
总耗时:1 分 03 秒
其中 ChatOllama 推理:1 分 02 秒
输入 Token:约 4000,输出 Token:84
LLM 推理是绝对瓶颈。但问题是,我之前明明已经为 PyTorch 配置好了 XPU 加速(model_kwargs={'device': 'xpu'}),为什么 Ollama 还是慢如蜗牛?
排查与定位
在终端执行 ollama ps,输出显示:
Plaintext
qwen2.5:3b 2.2 GB 100% CPU 4096
问题终于浮出水面:Ollama 根本没跑在 GPU 上,依然在吃 CPU。
翻看 Ollama 的启动日志,我找到了关键的一行提示:
Plaintext
msg="dropping integrated GPU; to enable, set OLLAMA_IGPU_ENABLE=1"
原来,Ollama 默认会出于稳定性考虑禁用集成显卡(包括我的 Intel Arc 核显),必须手动将其唤醒。
解决方案
设置两个关键环境变量并重启 Ollama 服务:
Bash
# 先停止 Ollama 服务
net stop Ollama

# 设置环境变量(永久生效可写入系统环境变量)
$env:OLLAMA_IGPU_ENABLE = "1"
$env:OLLAMA_VULKAN = "1"

# 重新启动服务
ollama serve
再次检查 ollama ps:
Plaintext
qwen2.5:3b 2.2 GB 100% GPU 4096
Ollama 终于顺利接管并运行在 GPU 上了。
本轮效果:推理速度直接提升了 2-3 倍,总响应时间从 60+ 秒降到了 40 秒左右。
2、优化Prompt减少Token:
问题分析
即使换上了 GPU 加速,响应时间依然有 40 秒左右。继续观察 Langfuse 的追踪链路,发现输入 Token 依然居高不下——接近 4000 Token。
解决方案
截断单个文档长度
修改
format_docs函数,硬性限制每个检索片段的最大字符数:Python
def format_docs(docs: list[Document], max_chars: int = 300) -> str:
    """将检索出来的 Document 拼接成文本,并截断每个文档的长度"""
    if not docs:
        return "暂无相关参考资料。"

    formatted = []
    for i, doc in enumerate(docs, 1):
        content = doc.page_content
        if len(content) > max_chars:
            content = content[:max_chars] + "..."
        formatted.append(f"[参考资料 {i}]:\n{content}")
    return "\n\n".join(formatted)
每个文档只截取前 300 个字符(约合 100-150 个中文词),足够覆盖核心信息。
精简 System Prompt
把原来冗长啰嗦的设定精简为直击要害的核心指令:
Plaintext
你是汽车售后客服。根据【参考知识库】回答用户的问题。

【参考知识库】:
{context}

【用户问题】:
{question}

规则:
1. 如果知识库有相关信息,礼貌回答。
2. 如果知识库没有相关信息,回复:“抱歉,该问题暂未收录,建议拨打官方热线咨询。”
3. 严禁凭空编造答案。
本轮效果:输入 Token 从 ~4000 锐减至 ~1500,响应时间顺势从 40 秒压到了 25 秒左右。
3、降低混合检索参数:
问题分析
运行时间25 秒,离流畅交互依然有一段距离。我重新审视了混合检索的参数 HYBRID_TOP_K:
它原本用于控制混合检索返回的初始候选池大小。
之前设置为 10,意味着先粗召回 10 条,再丢给重排序模型精筛出 3 条。
但问题在于:重排序本身需要计算开销,且候选池越大,拼出来的 Prompt 越长,最终反向拖慢了 LLM 生成。
实际上,在经过优质向量化和关键字检索的加持下,对于绝大多数垂直领域的问题,排名前 2 的文档已经足够覆盖正确答案。
解决方案
果断将参数收紧:
Python
# config.py
HYBRID_TOP_K: int = 4  # 从 10 改为 4
RERANK_TOP_N: int = 2  # 最终保留 2 条进入 Prompt
让混合检索只抓取最相关的 4 条核心文档,重排序模型也仅需对这 2 个候选对象做轻量打分。
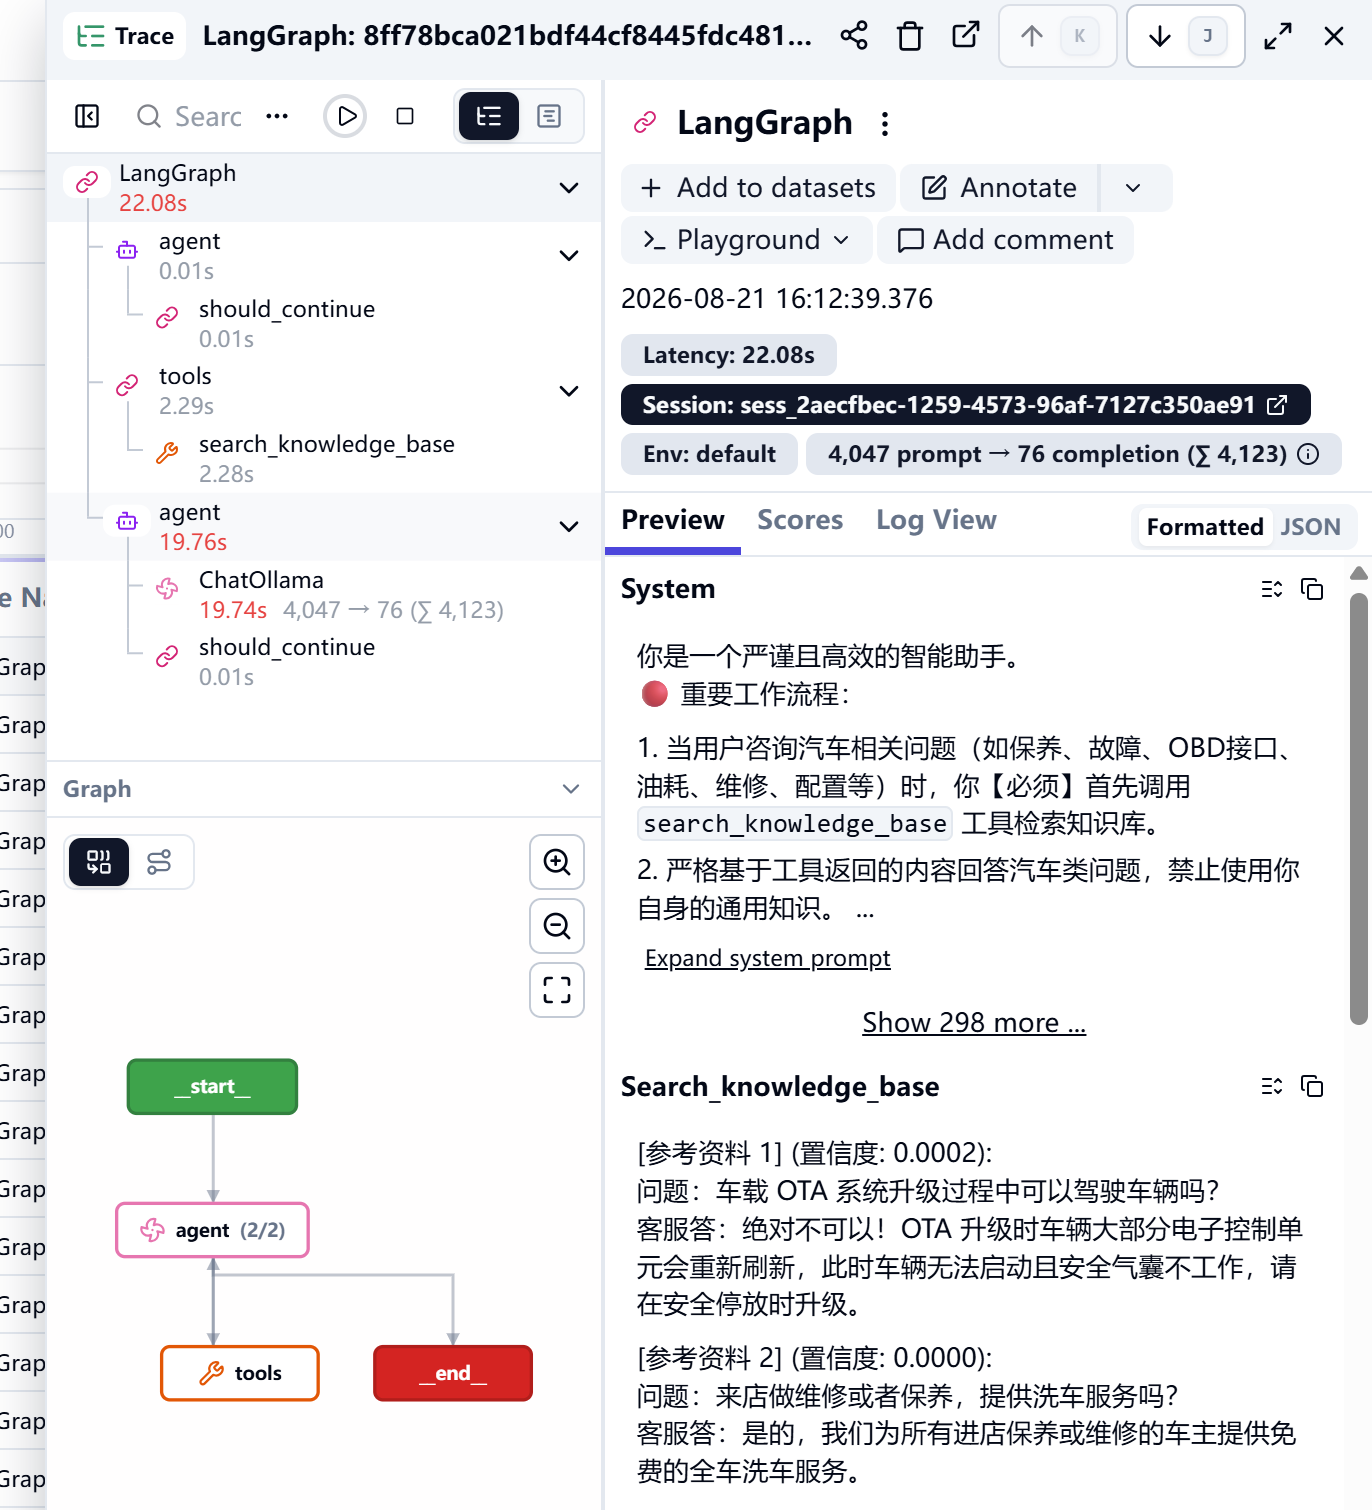
从10条改成了4条后,推理响应时间瞬间降到了19秒,如果把重排序也去掉,还能在节约2秒。
4、整理:
经过这几步操作下来,响应时间从1分多钟降到了20秒左右,输入token从4000+降到了1500,负载从CPU到GPU,充分利用本地笔记本电脑硬件优势。我的感觉是,优秀的架构设计与策略优化,远比盲目堆砌硬件配置来得重要。
下面放两张图,记录一下:
调试前的langfuse截图:
调试后的langfuse截图:
通过上面的图,可以看出,主要耗时集中在ChatOllama上,这是因为LangGraph的执行结果会再次扔给LLM,此时LLM拿到了大量的Tokey进行推理,受本地计算机影响,这个结果比较慢。如何才能更快,这个时候就需要做穿透回显,当使用multi-Agent技术的时候,由supervisor节点决定调用哪个工具,拿到结果后跳过二次LLM推理直接,会再次大幅缩减运行时间,关于这点下章会讲到。